
¿Y si preparar una clase fuera plantear una pregunta y obtener los pasajes correctos de los programas correctos, con las fuentes a la vista, en unos segundos?
Esa es la apuesta de wag.titcheur.fr, un motor de búsqueda semántica sobre los referenciales y programas de la enseñanza secundaria francesa: colegio, bachillerato general y tecnológico, y vía profesional.
El problema
Los programas oficiales son públicos, pero están dispersos en 5.680 documentos PDF, es decir, 4,9 GB de texto, miles de páginas y decenas de disciplinas. Encontrar "lo que dice el programa de matemáticas de 4ème sobre el teorema de Pitágoras" es casi una hazaña. Los motores clásicos buscan palabras; no entienden las preguntas.
La idea en 30 segundos
En lugar de buscar palabras clave, la herramienta entiende el significado.
Cada documento se divide en bloques de unos 700 caracteres (con solapamiento). Un modelo de IA bilingüe francés/inglés (bilingual-embedding-large, 559 M de parámetros) transforma cada uno de esos bloques en un vector de 1024 números, una especie de coordenada en un atlas semántico: dos textos que hablan de lo mismo aterrizan en el mismo lugar, aunque estén formulados de forma distinta.
Tu pregunta sufre la misma transformación. El sistema busca entonces sus vecinos más cercanos entre 234.893 bloques indexados: la búsqueda se convierte en un simple cálculo de distancias. Resultado: una consulta en francés natural, con o sin errores tipográficos, devuelve los pasajes oficiales pertinentes, ordenados por proximidad de sentido, con un enlace directo al PDF de origen.
Y con "Élaborer", un segundo modelo redacta una respuesta estructurada únicamente a partir de los extractos recuperados, con las fuentes citadas entre paréntesis.
Elegir el cerebro correcto con un benchmark
Un motor semántico vale lo que vale su modelo de embeddings. En lugar de seguir una tendencia o un post de blog, medí.
Construí un banco de pruebas aislado (500 documentos, 22.393 bloques, 30 preguntas reescritas a mano, 8 preguntas tipificadas por disciplina) y enfrenté tres modelos:
| Modelo | Recall a 10 | Pureza disciplinar | Latencia |
|---|---|---|---|
| bilingual-embedding-large (fr/en, 559M) | 0,867 | 0,900 | 56 ms |
| multilingual-e5-base (278M, el anterior) | 0,800 | 0,825 | 33 ms |
| gte-multilingual-base (305M) | 0,767 | 0,862 | 40 ms |
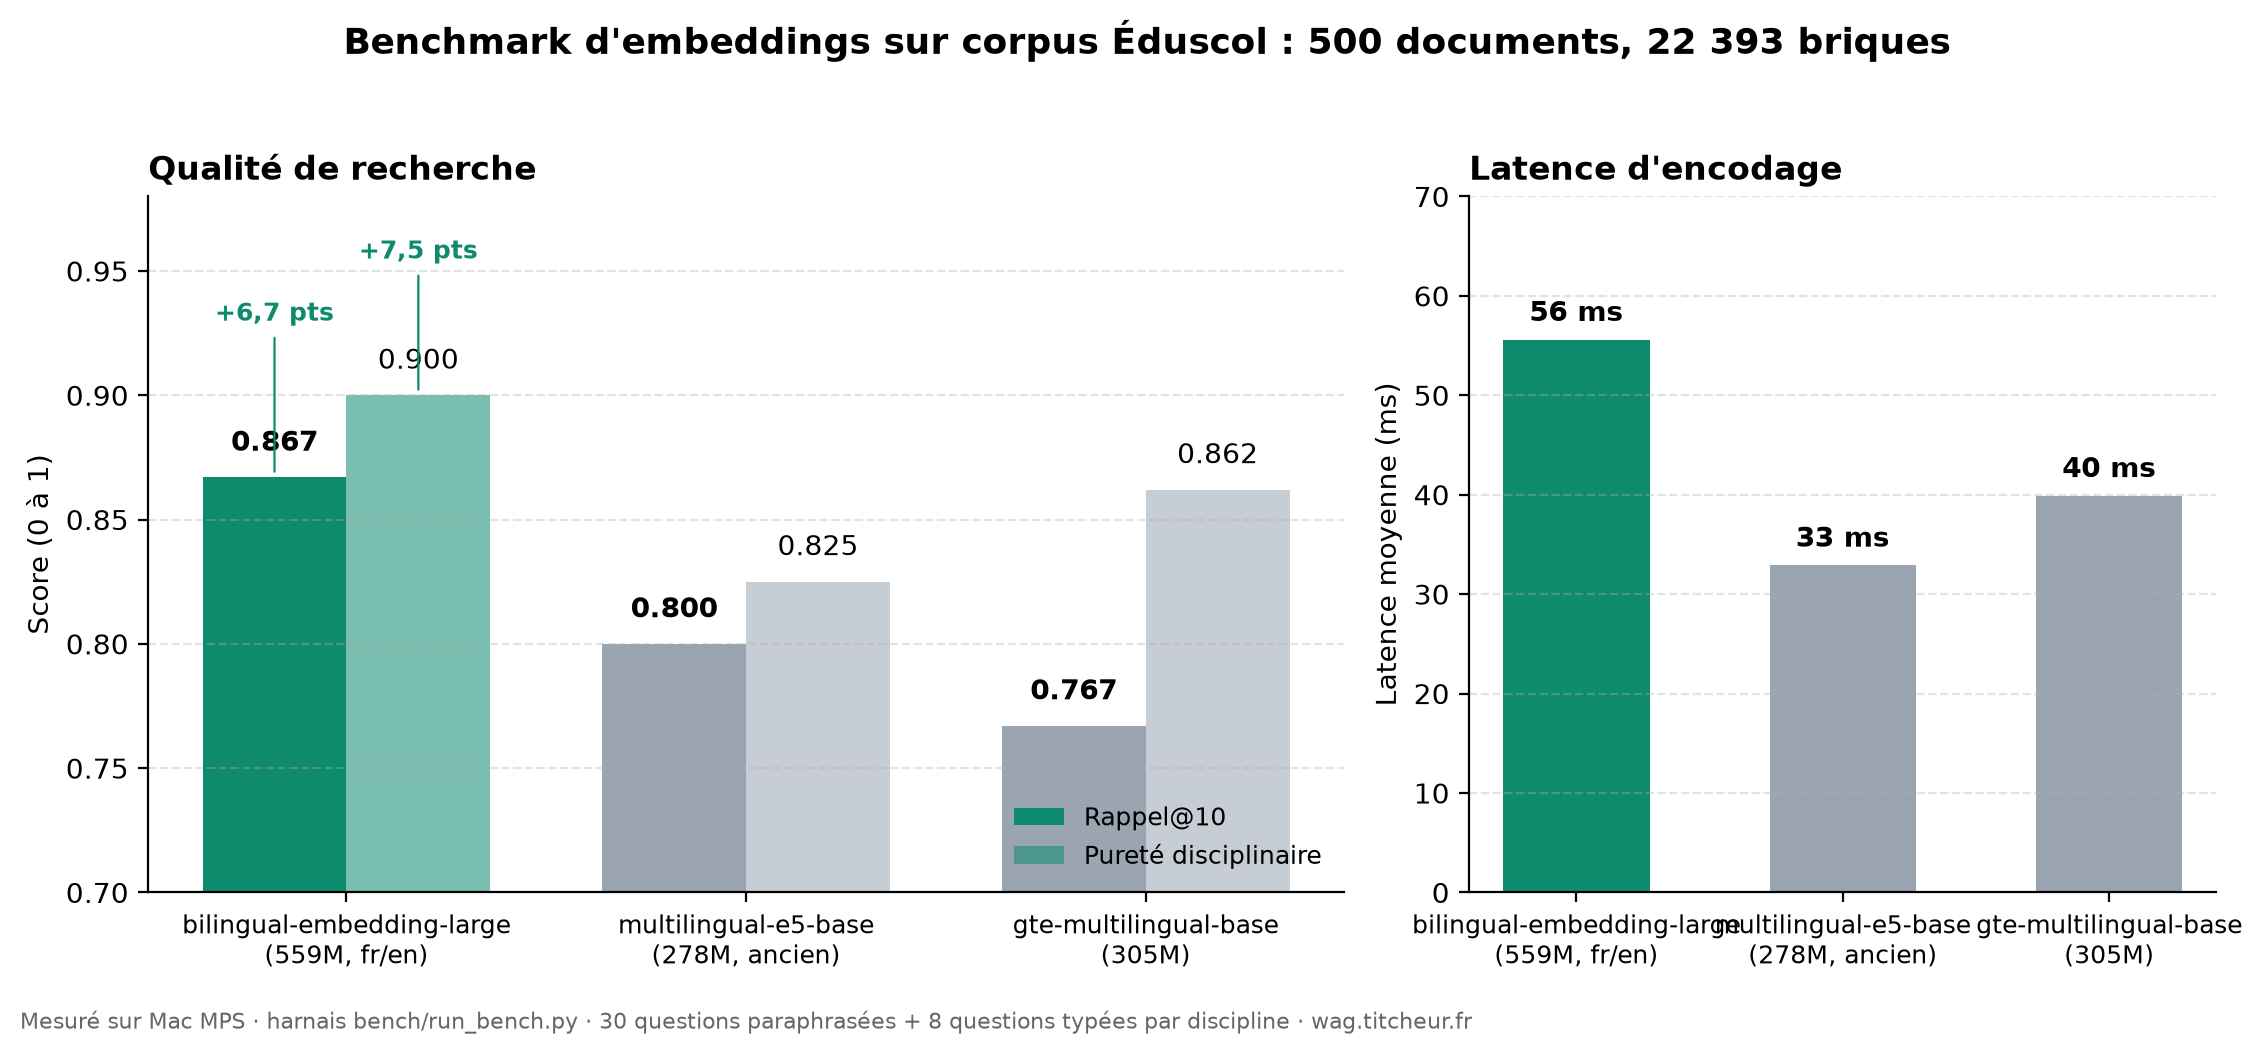
Veredicto: el modelo bilingüe francés-inglés bilingual-embedding-large gana por 7,5 puntos de pureza disciplinar y 6,7 puntos de recall. Moraleja: sobre un corpus francés, un modelo generalista multilingüe es superado por un modelo entrenado para el francés. El cambio está hecho. Pero cambiar de modelo es cambiar la dimensión de los vectores: toda la base se vuelve ilegible. La historia de esta migración merece su propio capítulo.
La bifurcación: 234.000 bloques calculados en una noche en un clúster "desechable"
Cambiar de modelo = cambiar la geometría de los vectores (768 → 1024 dimensiones). La base existente es incompatible: no hay delta posible, todo debe re-codificarse: 234.000 bloques.
Primera estimación en mi portátil (Apple Silicon M2/16): unos 2 s/documento al principio... y luego 9 a 10 s/documento en los PDF grandes. Extrapolación: una noche entera con la máquina inmovilizada.
El giro: un clúster k3s ya existente en Azure: 4 nodos, 32 vCPU, sin GPU, un free-tier que ya servía para otros experimentos. Cero infraestructura que crear. La receta, en aproximadamente 1 hora:
- Exportar el estado, no empezar de cero: 5 GB de PDF más la base SQLite más el índice parcial ya calculado (~900 MB) transferidos al clúster. El job es resumable: retoma exactamente donde se detuvo; las ~2 h de cálculo del portátil no se perdieron.
- Fragmentar el corpus en 4 rangos con solapamiento, uno por nodo, indexación en paralelo.
- Fusionar los shards por upsert (los solapamientos se deduplican solos), transferir el índice final y conmutar de forma atómica con rollback inmediato posible.
Resultados:
- 234.893 bloques re-codificados en ~4 h de cálculo repartido, frente a una noche en una sola máquina
- Coste total: menos de 10 $, facturación al minuto, las 4 VM desasignadas en cuanto termina el job
- Producción servida sin interrupción durante todo el cálculo; la búsqueda pública permaneció en línea con el índice antiguo hasta la conmutación
- Tres trampas de ChromaDB neutralizadas de paso (paginación de lecturas, límite de 5.461 entradas por inserción, atomicidad por documento), corregidas y versionadas
La lección que me llevo: un job batch bien diseñado (estado portable, reanudación, sharding, merge) es un dato, no un proceso. Se traslada de un portátil a un clúster en una hora, sin perder un solo bloque y sin pagar una infraestructura dedicada que dormiría el 99 % del tiempo.
Los stacks
- Python / FastAPI para la API, interfaz web depurada en JS puro
- ChromaDB (HNSW, espacio coseno) para la base vectorial
- Sentence-Transformers para los embeddings (
bilingual-embedding-large, 1024 dimensiones), con un detalle que importa: los prefijospassage:/query:que exige el modelo, sin los cuales la calidad se derrumba - DeepSeek en API para la síntesis; la búsqueda, por su parte, es 100 % local e instantánea (< 1 s)
- Docker no-root (
cap_drop: ALL), nginx + Let's Encrypt, CI/CD GitLab con SAST y detección de secretos, y un ciclo nocturno a las 3 de la mañana que reexplora las fuentes, reindexa las novedades y rota la base sin borrar la anterior - k3s sobre Azure (4 nodos, 32 vCPU, sin GPU) para los jobs batch desechables: reindexación completa en una noche, VM desasignadas en cuanto termina el job
Lo que el proyecto me enseñó (la parte que interesa a los ingenieros)
- El post-filtrado de una base vectorial es una trampa: filtrar después de la búsqueda ANN trunca los resultados de forma invisible. Le dediqué un día entero, con pruebas comparativas.
- Un motor público cuesta dinero por consulta en cuanto un LLM entra en el bucle: rate-limiting por IP (6 req/min) más baneo automático (fail2ban), o la factura lo acaba pagando.
- La seguridad de un servicio expuesto se gana con pequeños gestos: escape XSS de los metadatos, CORS restringido, claves SSH únicamente, cortafuegos mínimo y un registro de autenticación que ya mostraba intentos de fuerza bruta.
- Los datos van antes que el código: rotación staging/live de la base vectorial, rollback automático si el nuevo conjunto de índices no responde, y nunca un sobrescritura en caliente.
- Hacer benchmarks con tus propios datos: los rankings públicos (MTEB) no lo dicen todo. Sobre 500 documentos reales, la diferencia entre dos modelos creíbles resultó ser de 7 puntos. Son esos puntos los que marcan la diferencia entre una herramienta útil y un juguete.
Todo es observable en directo en la página: un micrográfico muestra la evolución incremental del índice, noche tras noche.
Por qué es útil
Para un docente: "probabilidades condicionales en première" → los contenidos, capacidades esperadas y demostraciones del programa, extractos exactos y PDF original. Para un formador, un inspector o un padre curioso: la misma puerta de entrada hacia lo que la institución dice realmente.
Y esto es solo el principio: el motor está diseñado para engullir otros corpus, primaria, superior, textos reglamentarios...
Pruébalo: https://wag.titcheur.fr, es gratuito, sin cuenta, y responde en francés.
¿Preguntas, comentarios, ideas de corpus? wag@titcheur.fr
Proyecto desarrollado para 199A Consulting: ingesta, indexación, endurecimiento y automatización de extremo a extremo.