
Was wäre, wenn Unterrichtsvorbereitung hieße, eine Frage zu stellen und in Sekunden die richtigen Passagen aus den richtigen Lehrplänen zu bekommen, mit Quellenangaben?
Das ist die Wette von wag.titcheur.fr, einer semantischen Suchmaschine über die Referenzwerke und Lehrpläne des französischen Sekundarschulwesens: Collège, allgemeinbildendes und technologisches Lycée sowie berufliche Bildung.
Das Problem
Die offiziellen Lehrpläne sind öffentlich, aber verstreut in 5.680 PDF-Dokumenten, also 4,9 GB Text, Tausenden von Seiten und Dutzenden von Fächern. Herauszufinden, "was der Mathematik-Lehrplan der 4ème zum Satz des Pythagoras sagt", grenzt an ein Kunststück. Klassische Suchmaschinen suchen Wörter; sie verstehen keine Fragen.
Die Idee in 30 Sekunden
Statt nach Schlagwörtern zu suchen, versteht das Werkzeug den Sinn.
Jedes Dokument wird in Abschnitte von rund 700 Zeichen zerlegt (mit Überlappung). Ein zweisprachiges KI-Modell Französisch/Englisch (bilingual-embedding-large, 559 Mio. Parameter) verwandelt jeden dieser Abschnitte in einen Vektor aus 1024 Zahlen, eine Art Koordinate in einem semantischen Atlas: Zwei Texte, die vom Gleichen handeln, landen am selben Ort, auch wenn sie anders formuliert sind.
Ihre Frage durchläuft dieselbe Transformation. Das System sucht dann ihre nächsten Nachbarn unter 234.893 indexierten Abschnitten: Die Suche wird zu einer einfachen Abstandsberechnung. Ergebnis: Eine Anfrage in natürlichem Französisch, mit oder ohne Tippfehler, liefert die relevanten offiziellen Passagen, sortiert nach Bedeutungsnähe, mit einem direkten Link zum Quell-PDF.
Und mit "Élaborer" verfasst ein zweites Modell eine strukturierte Antwort ausschließlich auf Basis der gefundenen Auszüge, mit Quellen in Klammern.
Das richtige Gehirn per Benchmark wählen
Eine semantische Suchmaschine ist so viel wert wie ihr Embedding-Modell. Statt einem Trend oder einem Blogpost zu folgen, habe ich gemessen.
Ich habe eine isolierte Benchmark-Umgebung gebaut (500 Dokumente, 22.393 Abschnitte, 30 von Hand umformulierte Fragen, 8 nach Fach typisierte Fragen) und drei Modelle gegenübergestellt:
| Modell | Recall bei 10 | Fachliche Reinheit | Latenz |
|---|---|---|---|
| bilingual-embedding-large (fr/en, 559M) | 0,867 | 0,900 | 56 ms |
| multilingual-e5-base (278M, das alte) | 0,800 | 0,825 | 33 ms |
| gte-multilingual-base (305M) | 0,767 | 0,862 | 40 ms |
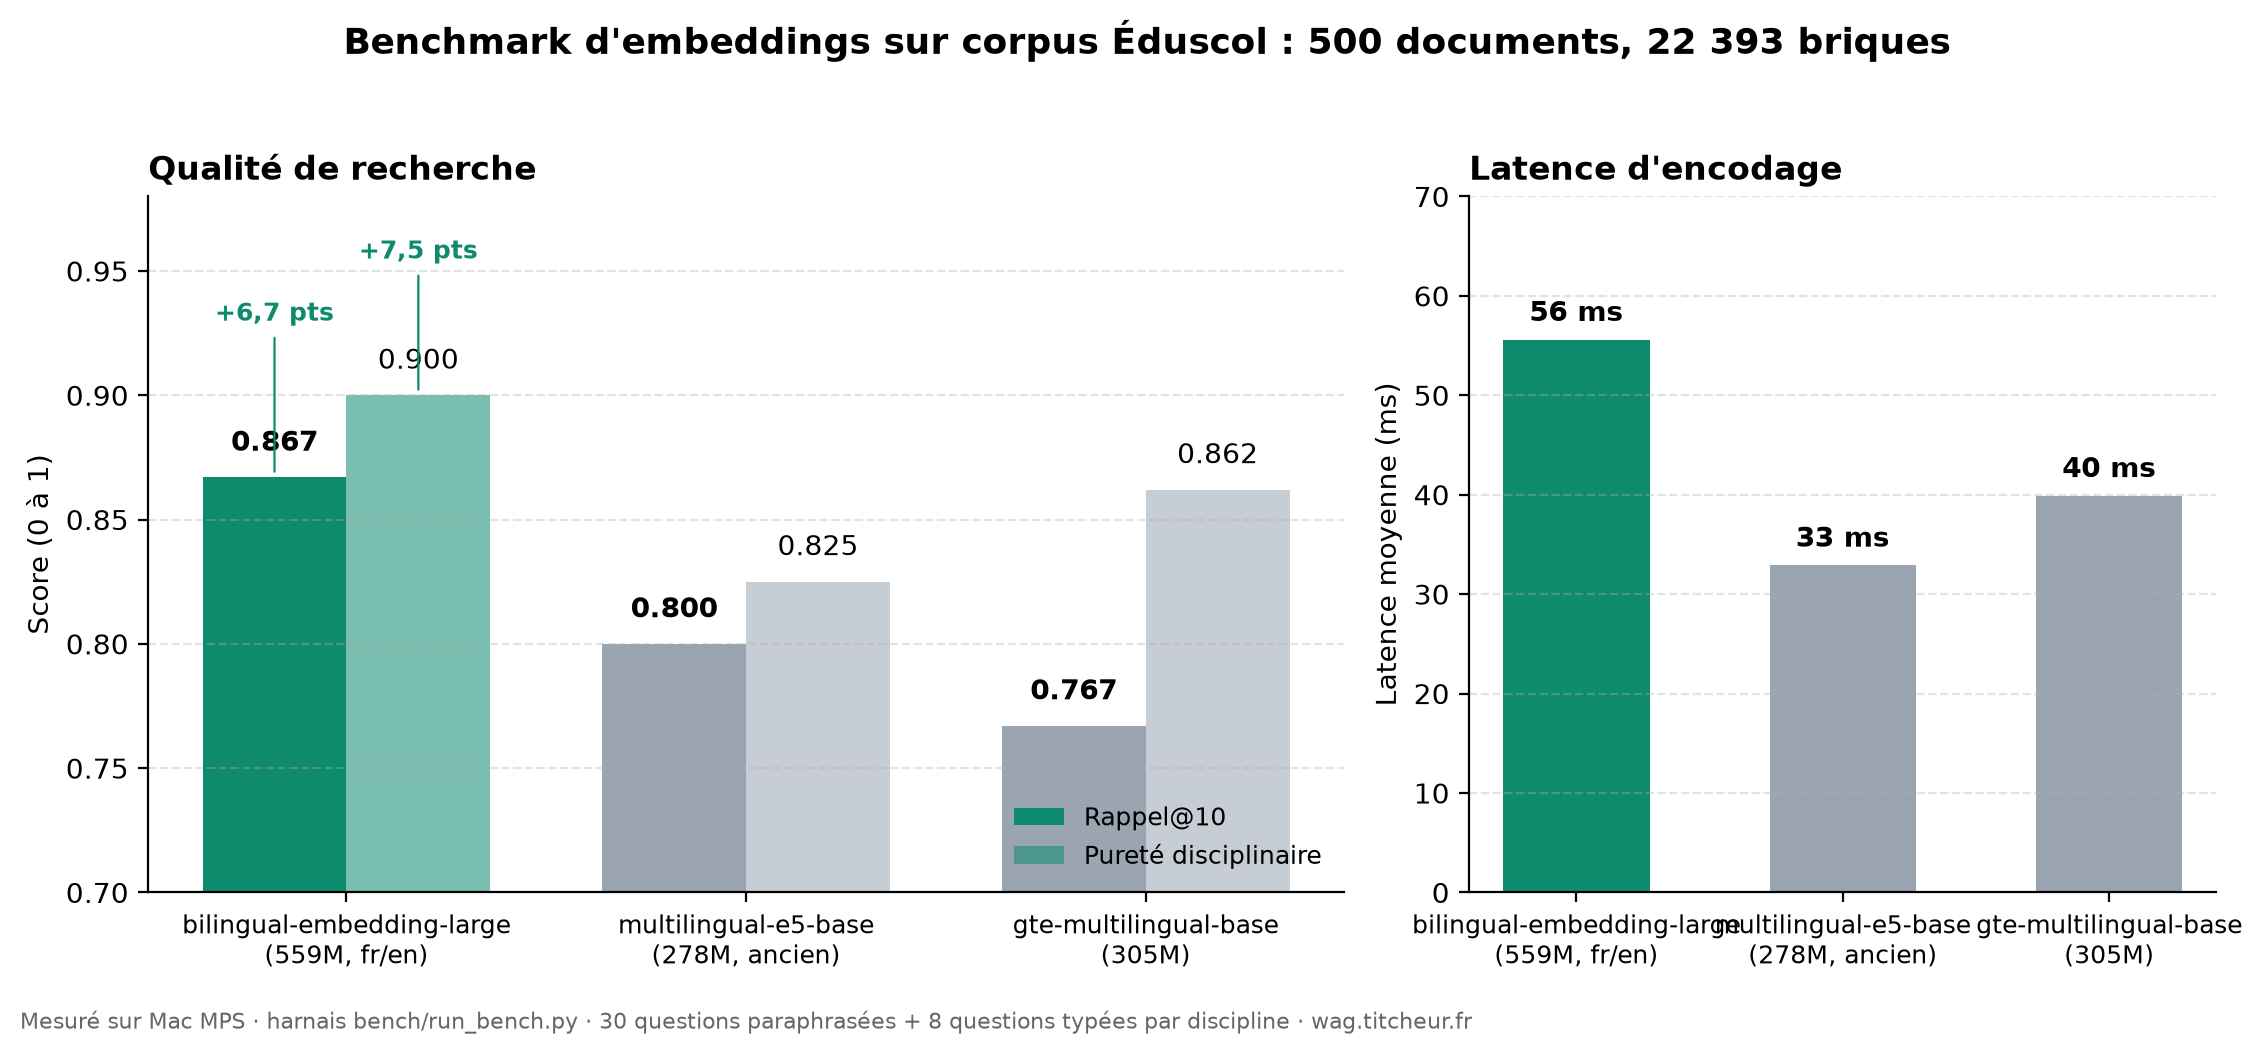
Fazit: Das zweisprachige Modell Französisch-Englisch bilingual-embedding-large gewinnt 7,5 Punkte fachliche Reinheit und 6,7 Punkte Recall. Moral: Auf einem französischen Korpus wird ein multilinguales Allzweckmodell von einem für Französisch trainierten Modell geschlagen. Die Umstellung ist erfolgt. Doch ein Modellwechsel bedeutet einen Wechsel der Vektordimension: Die gesamte Datenbank wird unlesbar. Die Geschichte dieser Migration verdient ein eigenes Kapitel.
Die Weggabelung: 234.000 Abschnitte an einem Abend auf einem "Einweg"-Cluster berechnet
Ein Modellwechsel bedeutet einen Wechsel der Vektor-Geometrie (768 → 1024 Dimensionen). Die bestehende Datenbank ist inkompatibel: Es gibt kein Delta, alles muss neu kodiert werden: 234.000 Abschnitte.
Erste Schätzung auf meinem Laptop (Apple Silicon M2/16): anfangs rund 2 s pro Dokument... dann 9 bis 10 s pro Dokument bei den großen PDFs. Hochrechnung: eine ganze Nacht mit blockierter Maschine.
Der Wendepunkt: ein bereits vorhandener k3s-Cluster auf Azure: 4 Knoten, 32 vCPU, ohne GPU, ein Free-Tier, der schon für andere Experimente diente. Keine Infrastruktur einzurichten. Das Rezept, in rund 1 Stunde:
- Den Zustand exportieren, nicht bei null anfangen: 5 GB PDF plus die SQLite-Datenbank plus der bereits berechnete Teilindex (~900 MB) auf den Cluster übertragen. Der Job ist resumable: Er setzt exakt dort fort, wo er aufgehört hat; die rund 2 h Rechenzeit des Laptops waren nicht verloren.
- Den Korpus in 4 Bereiche mit Überlappung sharden, einen pro Knoten, Indexierung parallel.
- Die Shards per Upsert zusammenführen (Überlappungen deduplizieren sich von selbst), den finalen Index übertragen und atomar umschalten, mit sofort möglichem Rollback.
Ergebnisse:
- 234.893 Abschnitte in ~4 h verteilter Rechenzeit neu kodiert, statt einer Nacht auf einer einzigen Maschine
- Gesamtkosten: weniger als 10 $, Abrechnung pro Minute, die 4 VMs sofort nach Job-Ende freigegeben
- Produktion unterbrechungsfrei bedient während der gesamten Berechnung; die öffentliche Suche blieb mit dem alten Index online bis zur Umschaltung
- Drei ChromaDB-Fallen nebenbei entschärft (Paginierung der Lesevorgänge, Limit von 5.461 Einträgen pro Einfügung, Atomizität pro Dokument), korrigiert und versioniert
Die Lehre, die ich mitnehme: Ein gut entworfener Batch-Job (portabler Zustand, Wiederaufnahme, Sharding, Merge) ist ein Datum, kein Prozess. Man verschiebt ihn in einer Stunde von einem Laptop auf einen Cluster, ohne einen einzigen Abschnitt zu verlieren und ohne eine dedizierte Infrastruktur zu bezahlen, die 99 % der Zeit schlafen würde.
Die Stacks
- Python / FastAPI für die API, aufgeräumte Weboberfläche in reinem JS
- ChromaDB (HNSW, Kosinusraum) für die Vektordatenbank
- Sentence-Transformers für die Embeddings (
bilingual-embedding-large, 1024 Dimensionen), mit einem entscheidenden Detail: den vom Modell geforderten Präfixenpassage:/query:, ohne die die Qualität einbricht - DeepSeek per API für die Synthese; die Suche selbst ist 100 % lokal und sofort (< 1 s)
- Docker non-root (
cap_drop: ALL), nginx + Let's Encrypt, CI/CD GitLab mit SAST und Secret Detection sowie ein nächtlicher Zyklus um 3 Uhr morgens, der die Quellen neu crawlt, Neues reindexiert und die Datenbank rotiert, ohne die alte zu löschen - k3s auf Azure (4 Knoten, 32 vCPU, ohne GPU) für Einweg-Batch-Jobs: vollständige Reindexierung an einem Abend, VMs sofort nach Job-Ende freigegeben
Was das Projekt mich gelehrt hat (der Teil, der Ingenieure interessiert)
- Das Post-Filtern einer Vektordatenbank ist eine Falle: Nach der ANN-Suche zu filtern, schneidet Ergebnisse unsichtbar ab. Dafür habe ich einen Tag verloren, mit vergleichenden Tests.
- Eine öffentliche Suchmaschine kostet Geld pro Anfrage, sobald ein LLM im Spiel ist: Rate-Limiting pro IP (6 Anfragen/Min.) plus automatische Sperre (fail2ban), sonst zahlt die Rechnung.
- Die Sicherheit eines exponierten Dienstes gewinnt man mit kleinen Gesten: XSS-Escaping der Metadaten, eingeschränktes CORS, ausschließlich SSH-Schlüssel, minimale Firewall und ein Auth-Log, das bereits Brute-Force-Versuche zeigte.
- Die Daten kommen vor dem Code: Staging/Live-Rotation der Vektordatenbank, automatischer Rollback, wenn der neue Index nicht antwortet, niemals ein Überschreiben im laufenden Betrieb.
- Auf den eigenen Daten benchmarken: Öffentliche Rankings (MTEB) sagen nicht alles. Bei 500 echten Dokumenten betrug der Abstand zwischen zwei glaubwürdigen Modellen 7 Punkte. Genau diese Punkte entscheiden zwischen einem nützlichen Werkzeug und einem Spielzeug.
Alles ist live auf der Seite beobachtbar: Eine Mikrografik zeigt die inkrementelle Entwicklung des Index, Nacht für Nacht.
Warum das nützlich ist
Für eine Lehrkraft: "bedingte Wahrscheinlichkeiten in der Première" → die Inhalte, erwarteten Kompetenzen und Beweise des Lehrplans, exakte Auszüge und Original-PDF. Für eine Trainerin, einen Inspektor oder neugierige Eltern: dieselbe Tür zu dem, was die Institution wirklich sagt.
Und das ist erst der Anfang: Die Suchmaschine ist darauf ausgelegt, weitere Korpora zu verschlingen, Grundschule, Hochschule, regulatorische Texte...
Probieren Sie es aus: https://wag.titcheur.fr, kostenlos, ohne Konto, und antwortet auf Französisch.
Fragen, Feedback, Ideen für Korpora? wag@titcheur.fr
Projekt entwickelt für 199A Consulting: Ingestion, Indexierung, Härtung und Automatisierung von Ende zu Ende.